← Home
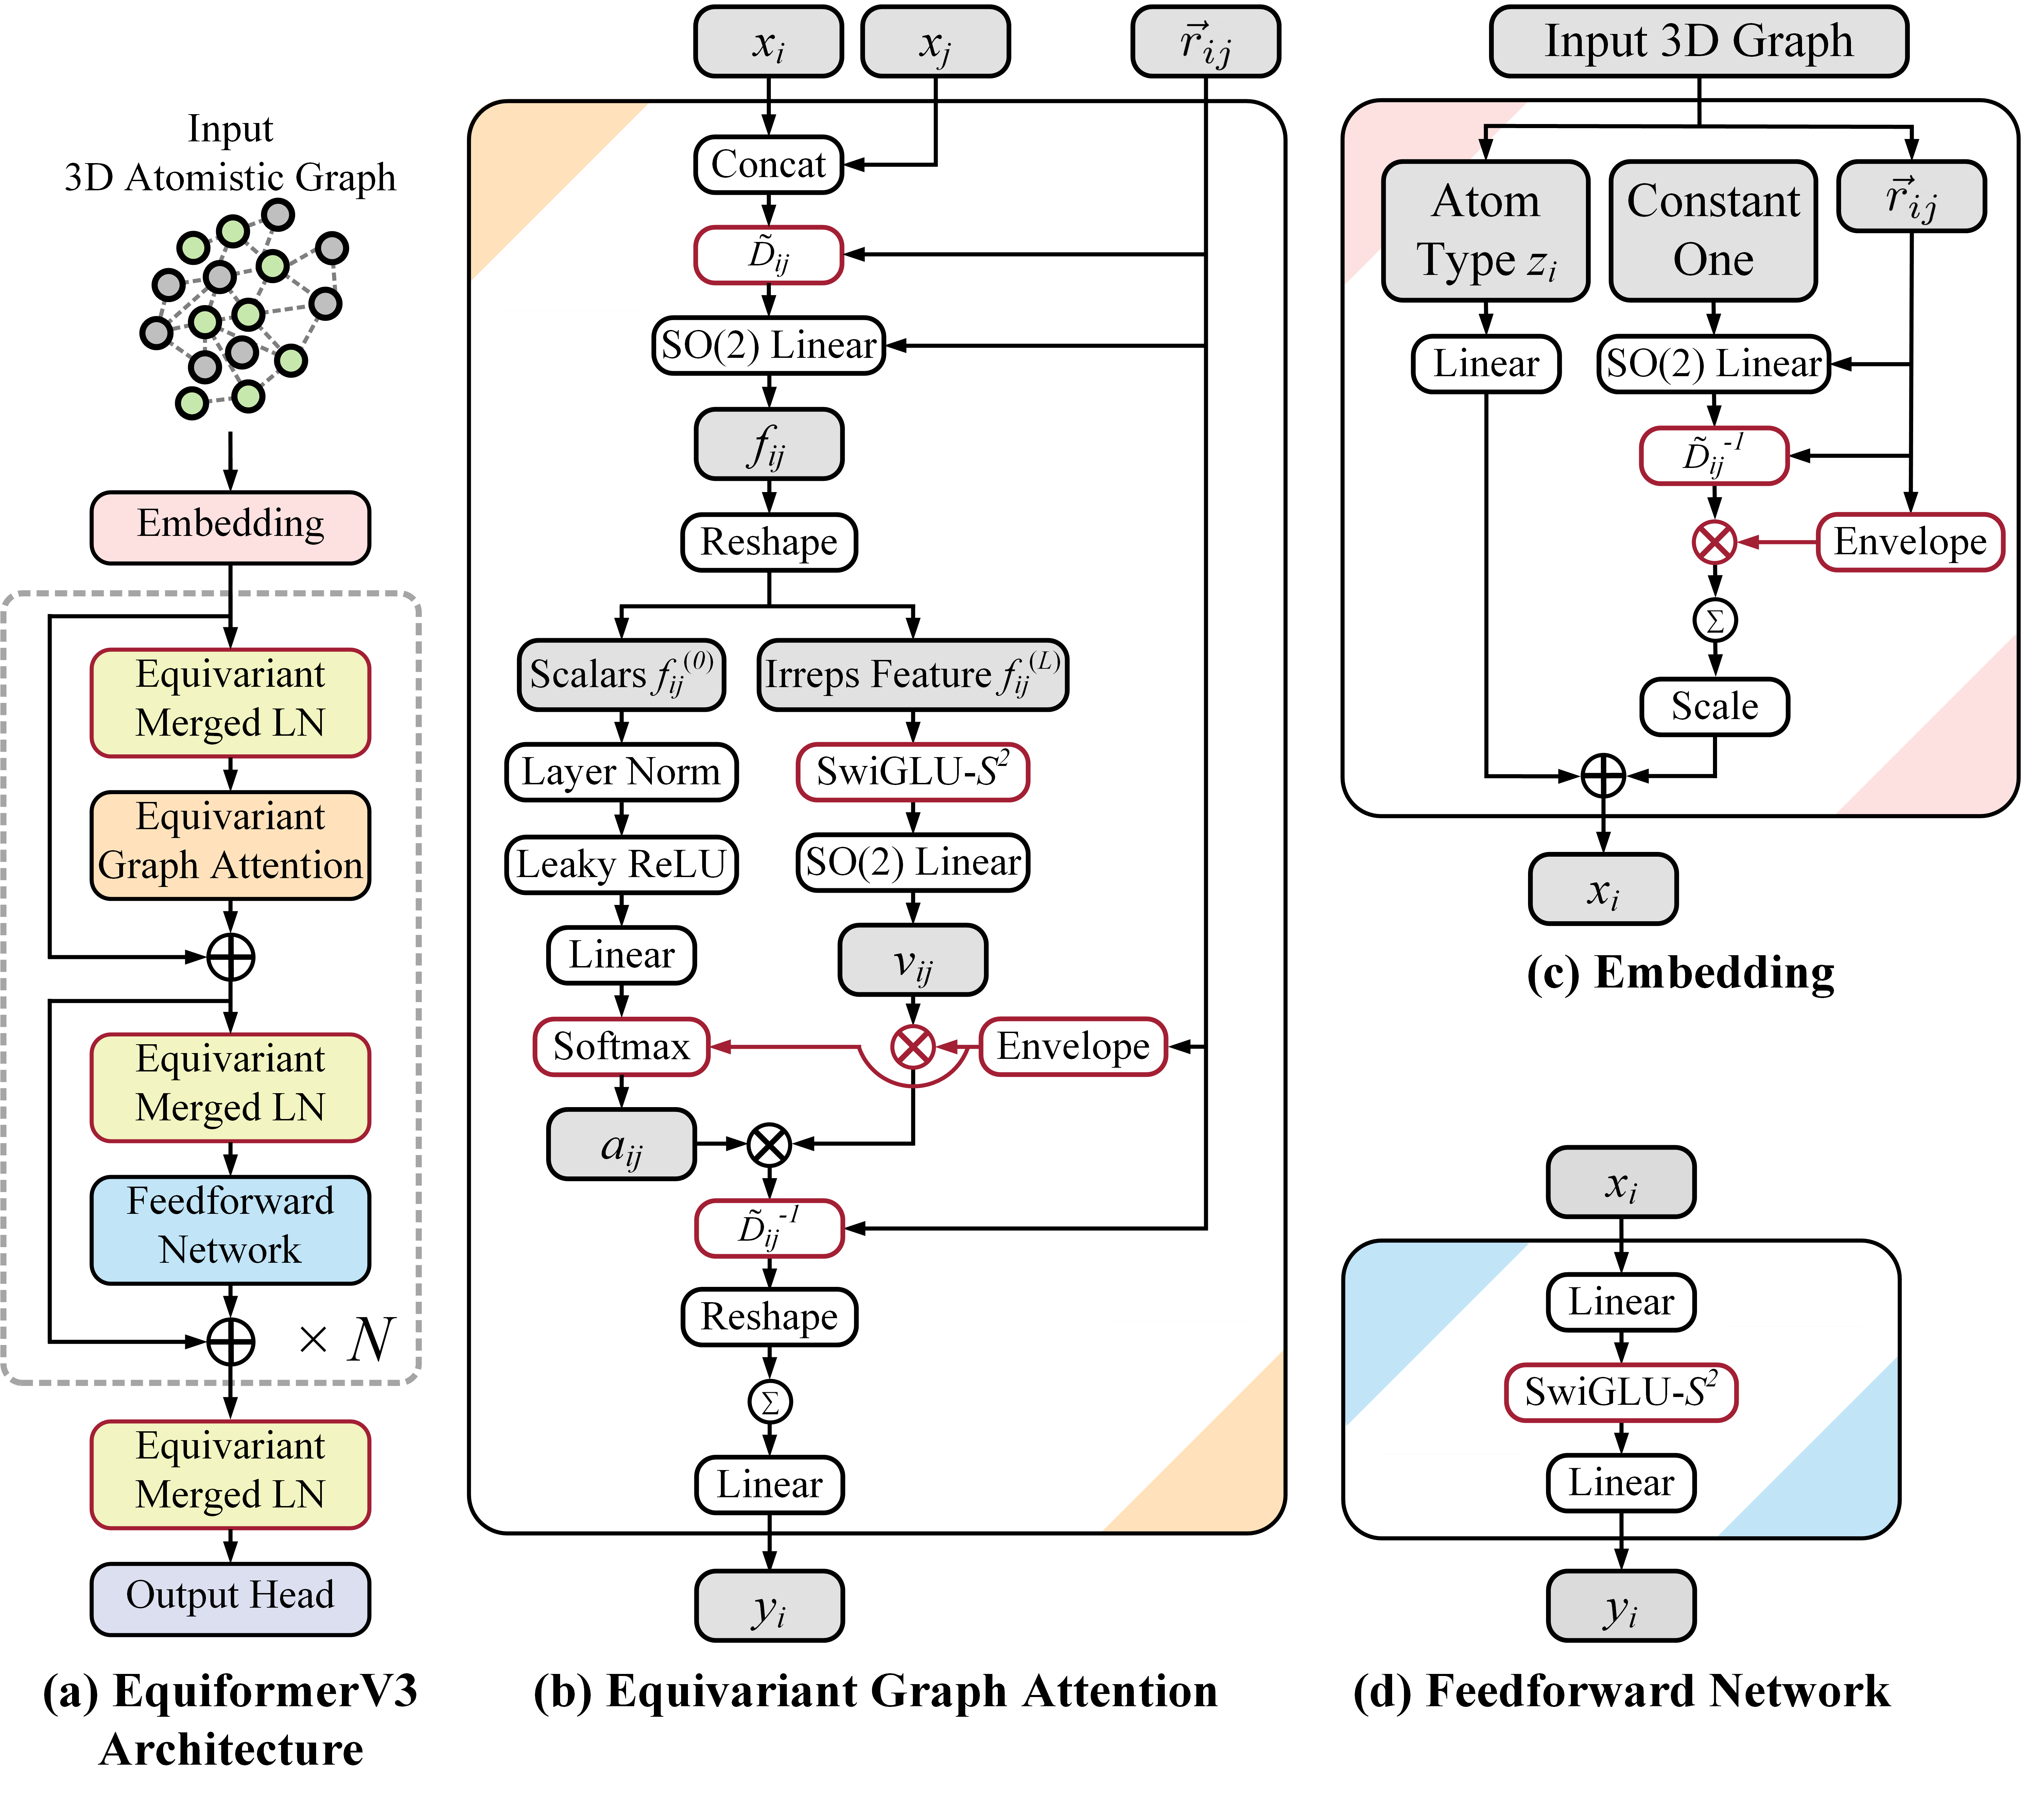
EquiformerV3: Scaling Efficient, Expressive, and General SE(3)-Equivariant Graph Attention Transformers
Yi-Lun Liao, Alexander J. Hoffman, Sabrina C. Shen, Alexandre Duval, Sam Walton Norwood, Tess Smidt
arXiv 2026 / paper / code
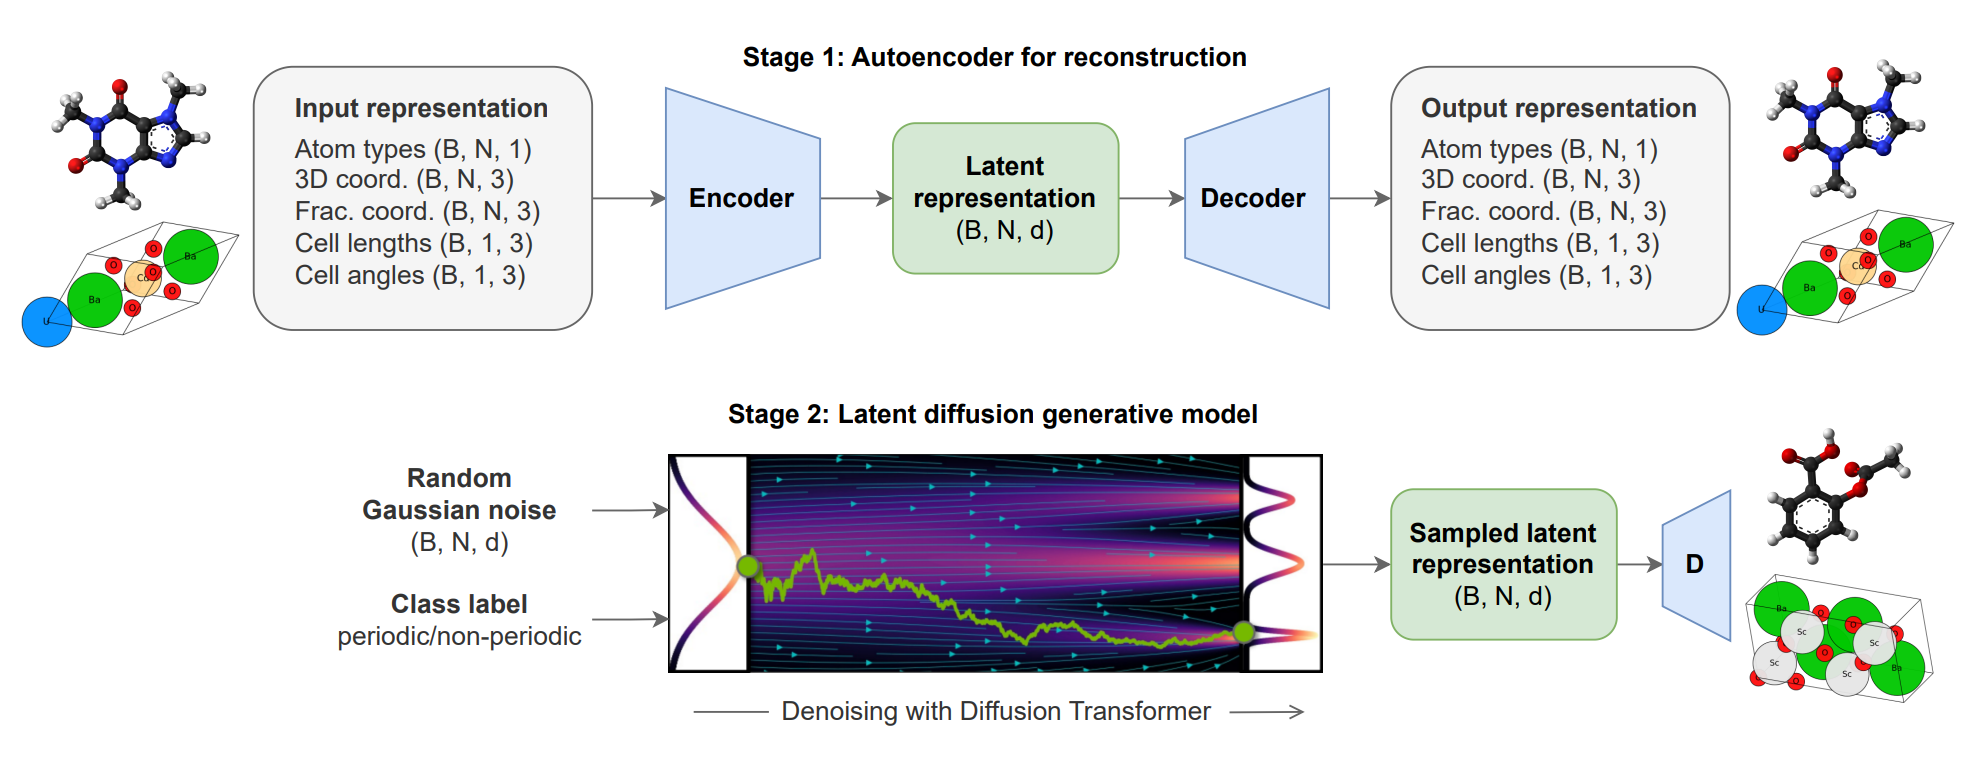
All-atom Diffusion Transformers: Unified Generative Modelling of Molecules and Materials
Chaitanya K. Joshi, Xiang Fu, Yi-Lun Liao, Vahe Gharakhanyan, Benjamin Kurt Miller, Anuroop Sriram, Zachary W. Ulissi
ICML 2025 / paper / code
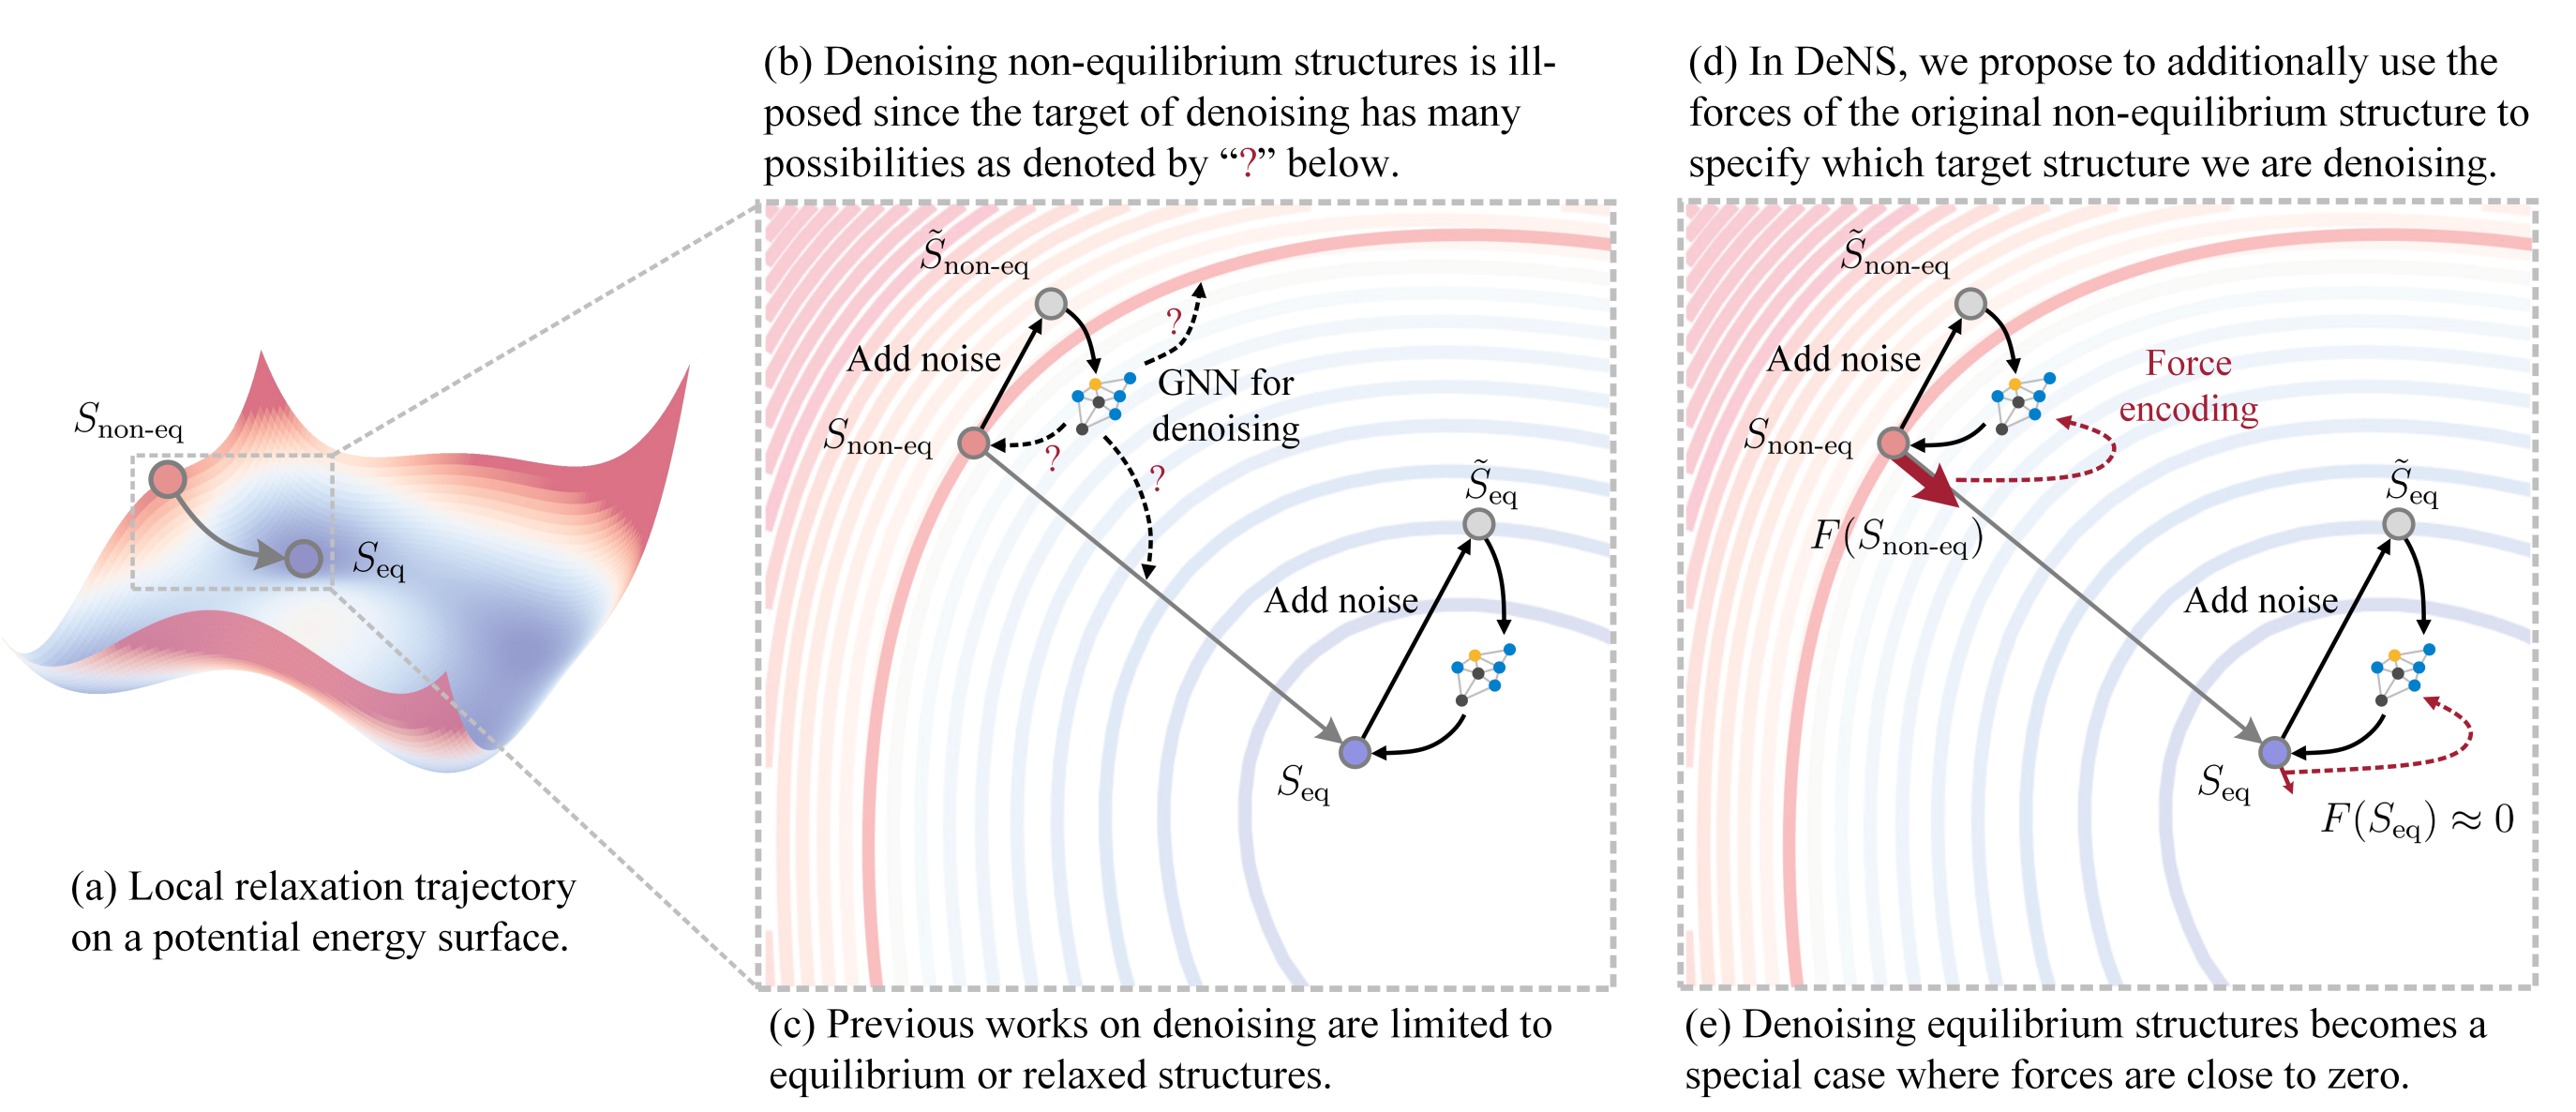
Generalizing Denoising to Non-Equilibrium Structures Improves Equivariant Force Fields
Yi-Lun Liao, Tess Smidt, Muhammed Shuaibi*, Abhishek Das*
TMLR 2024 (J2C Certification) / paper / code
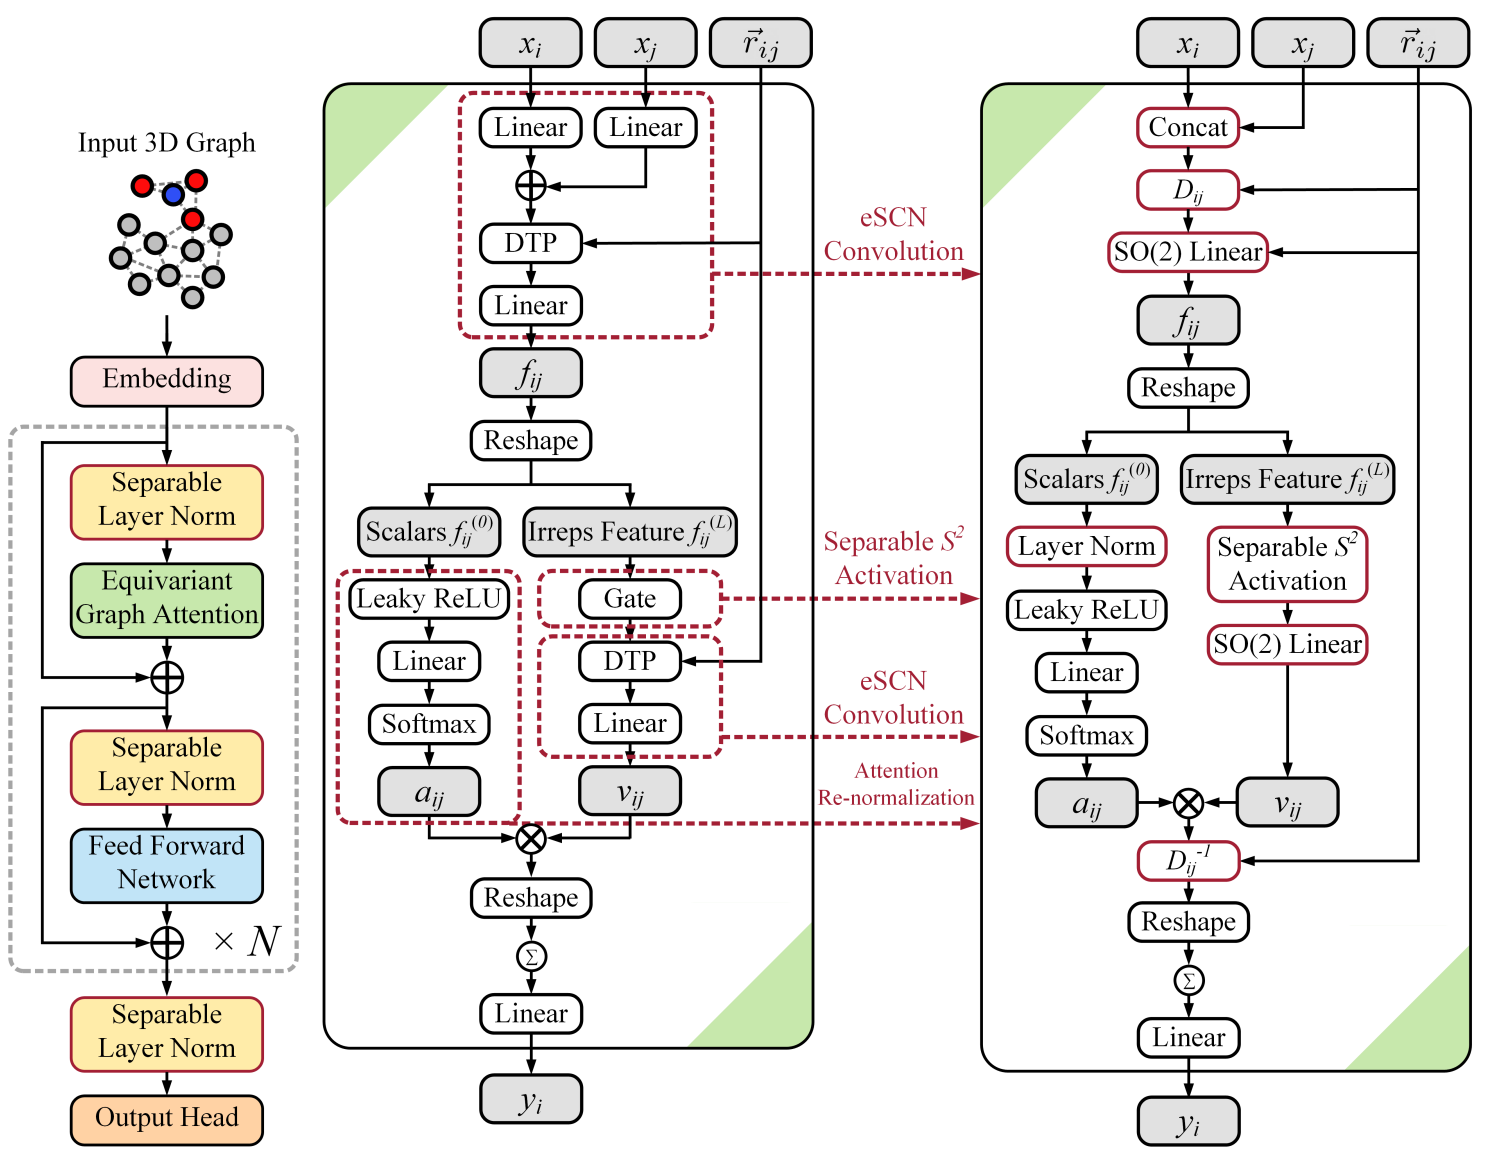
EquiformerV2: Improved Equivariant Transformer for Scaling to Higher-Degree Representations
Yi-Lun Liao, Brandon Wood, Abhishek Das*, Tess Smidt*
ICLR 2024 / paper / code
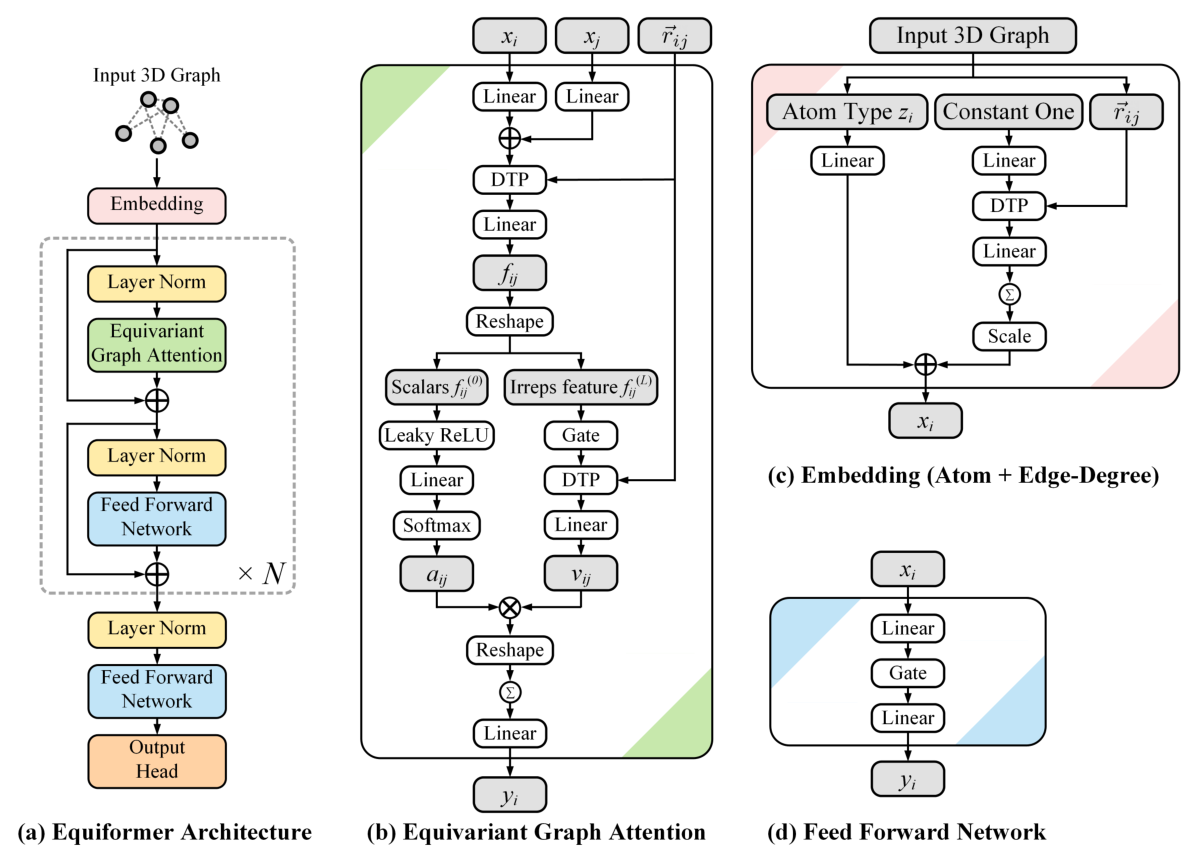
Equiformer: Equivariant Graph Attention Transformer for 3D Atomistic Graphs
Yi-Lun Liao, Tess Smidt
ICLR 2023 (Spotlight) / paper / code
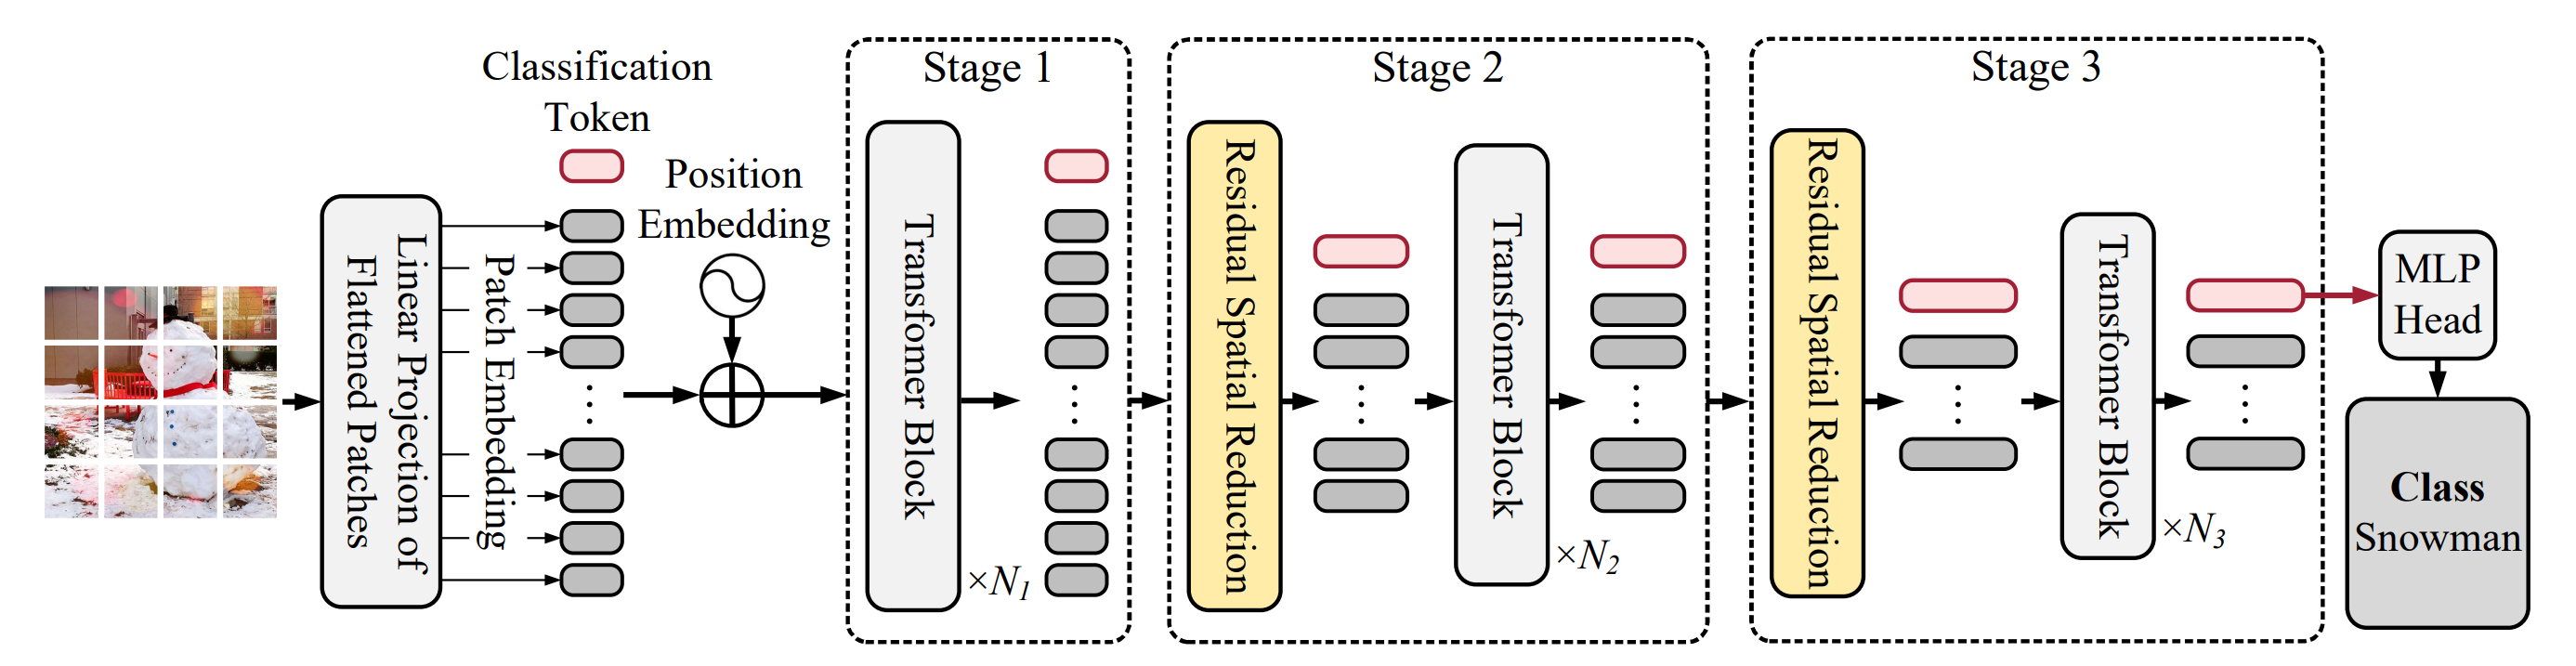
Searching for Efficient Multi-Stage Vision Transformers
Yi-Lun Liao, Sertac Karaman, Vivienne Sze
arXiv 2021 / paper / code
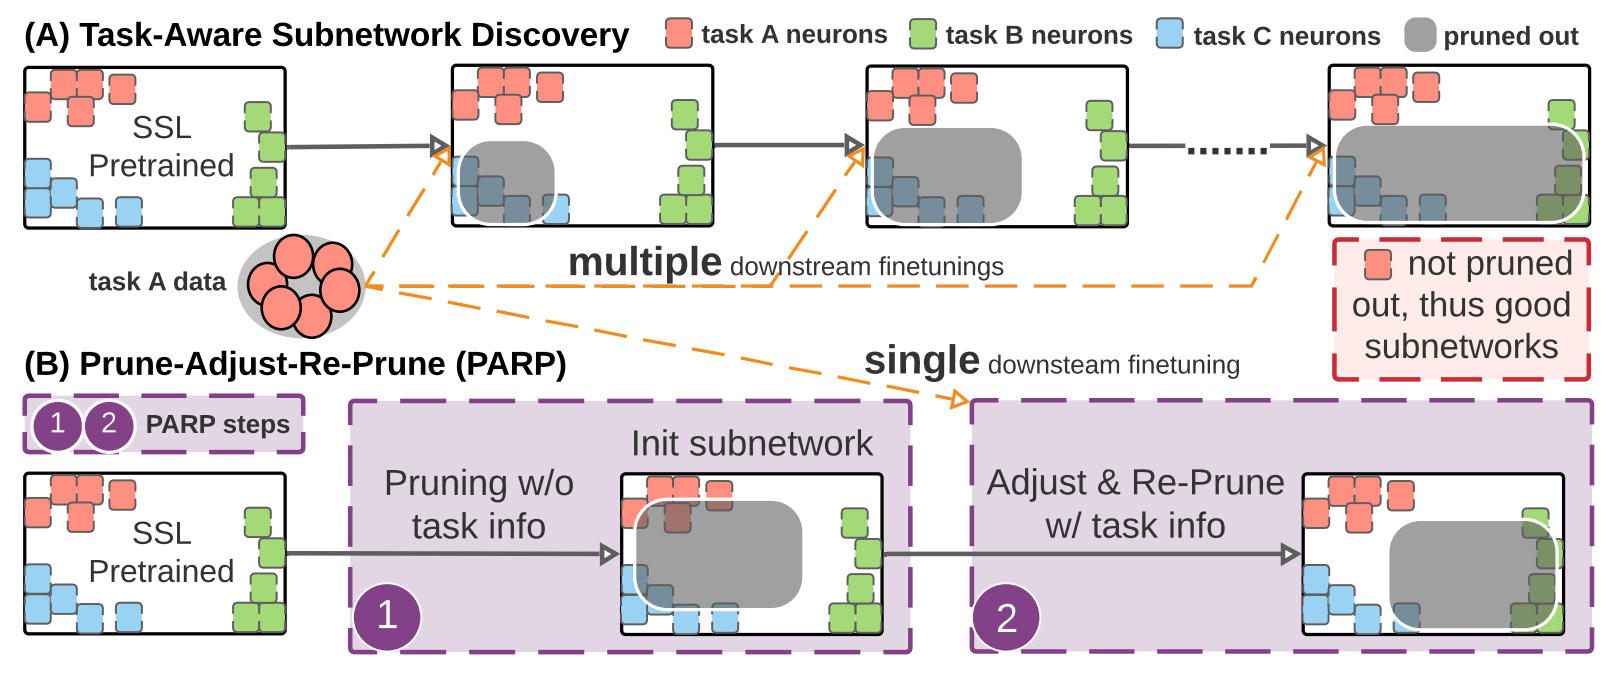
PARP: Prune, Adjust and Re-Prune for Self-Supervised Speech Recognition
Cheng-I Jeff Lai, Yang Zhang*, Alexander H. Liu*, Shiyu Chang*, Yi-Lun Liao, Yung-Sung Chuang, Kaizhi Qian, Sameer Khurana, David Cox, James Glass
NeurIPS 2021 (Spotlight) / paper
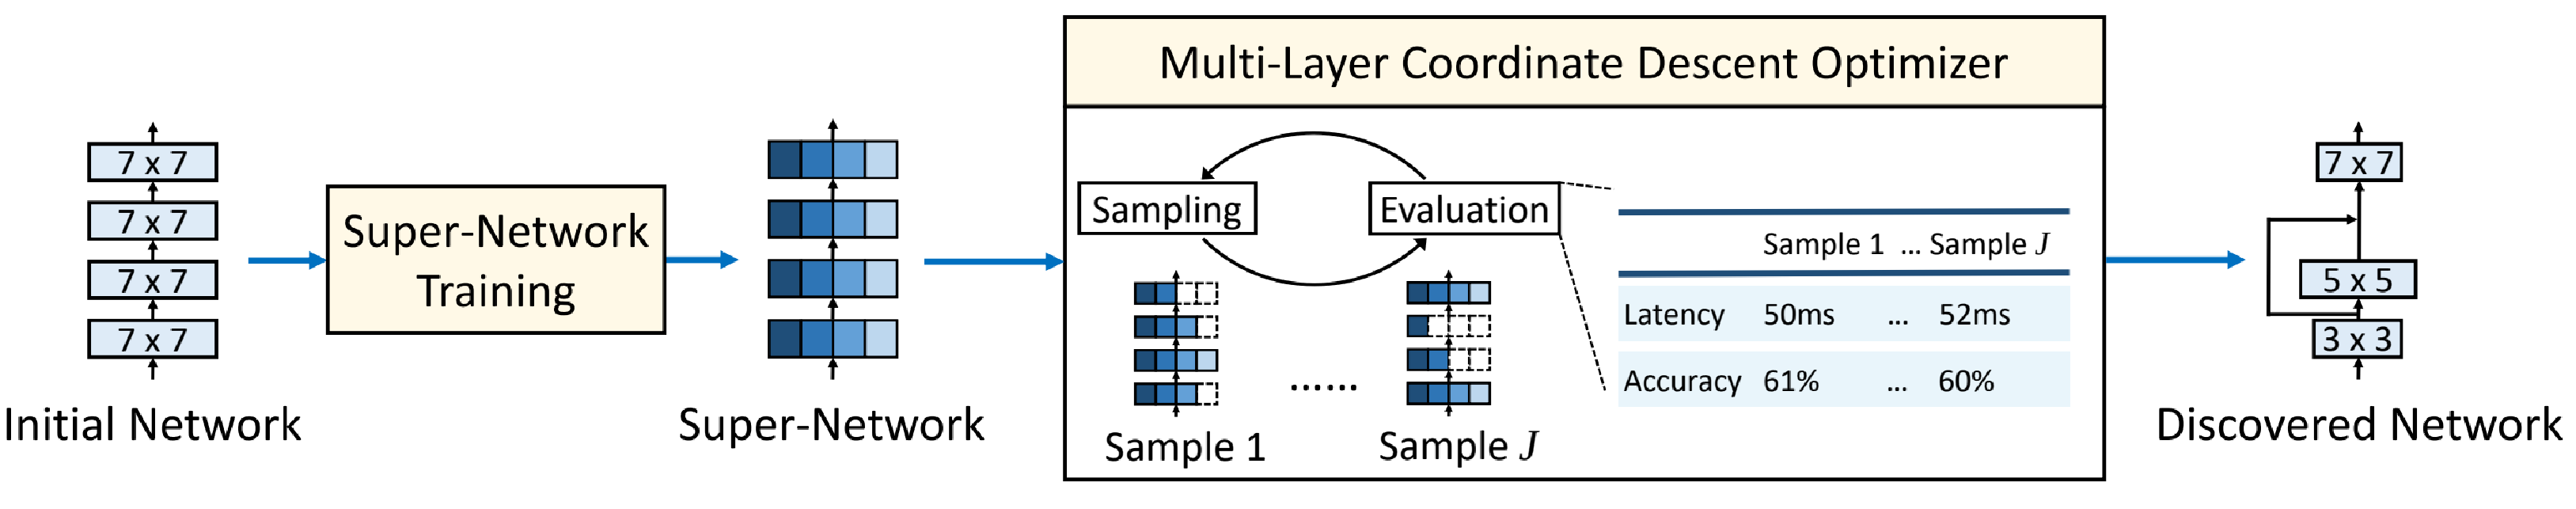
NetAdaptV2: Efficient Neural Architecture Search with Fast Super-Network Training and Architecture Optimization
Tien-Ju Yang, Yi-Lun Liao, Vivienne Sze
CVPR 2021 / paper